DEVELOPER’s BLOG
技術ブログ
エンタープライズDXでSREが進まない「責任境界の断絶」を突破する推進プロトコル
「SREを入れたのに、改善がまったく進まない」----。
監視の仕組みを整え、セキュリティの方針もまとめ、改善課題をチケットにきちんと起票した。
それなのに、課題は「開発ベンダー様にご確認中」のまま何か月も止まっている。
定例会議では毎回「進捗なし。確認次第共有します」という報告が続く。
そんな経験はないでしょうか。
エンタープライズのDXの現場では、1社のシステムを複数の開発ベンダーが分担していることがよくあります。
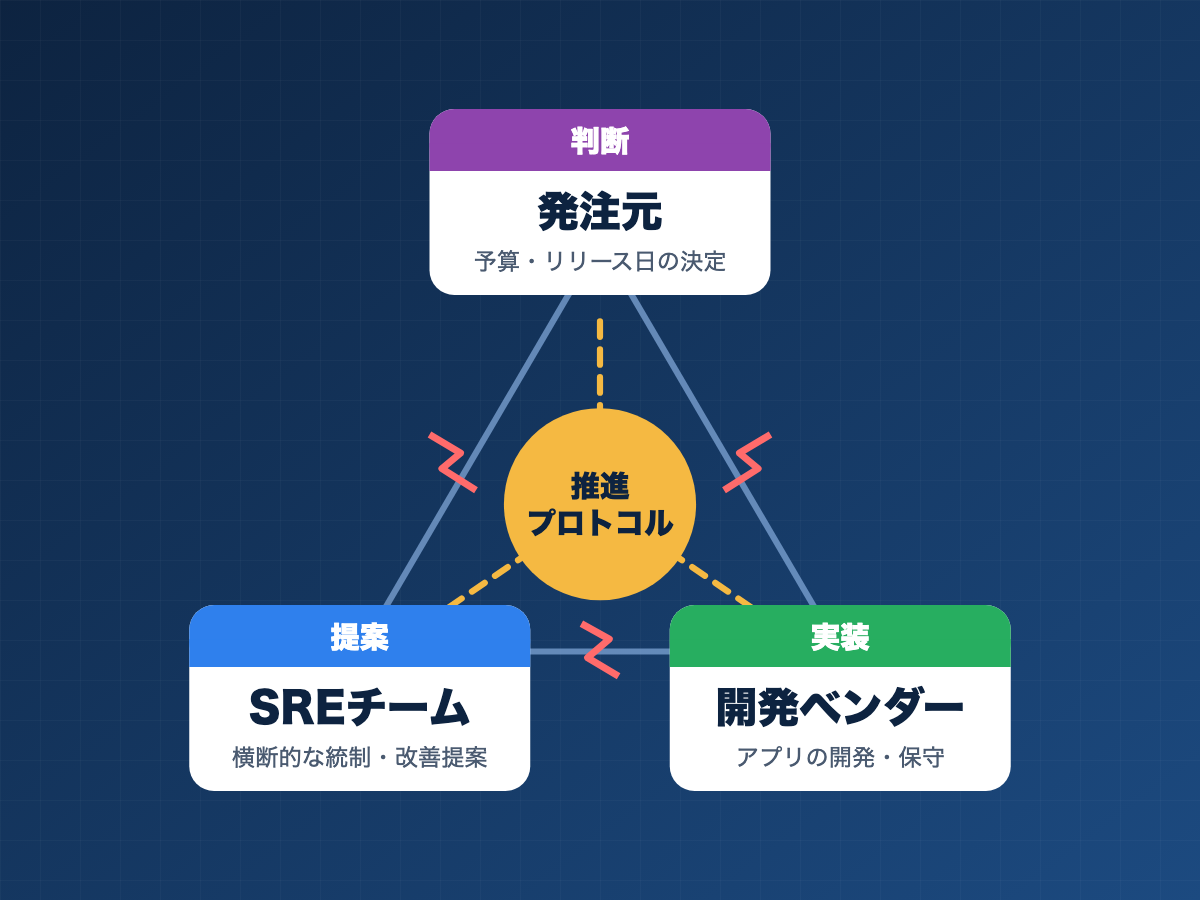
そこにSREチームが加わると、「改善を提案する人」「実際に手を動かす人」「やるかどうかを判断する人」がそれぞれ別の会社になるという問題が起きます。
私たちはこれを「責任境界の断絶」と呼んでいます。
当社は、複数の開発ベンダーが関わるエンタープライズ企業のAWS環境で、SREを担当してきました。
本記事では、その経験をもとに次の3点をまとめます。
- 改善が止まる原因は「ベンダーのやる気」ではなく、どんな仕組みにあるのか
- 改善を前に進めるための、折衝と推進のやり方(プロトコル)
- それでも残る課題
同じような体制でSREに取り組む方の参考になれば幸いです。
目次
1. 体制の全体像 -- 誰が何を持っているのか
最初に、マルチベンダー環境でよくある関係者と役割を整理します。
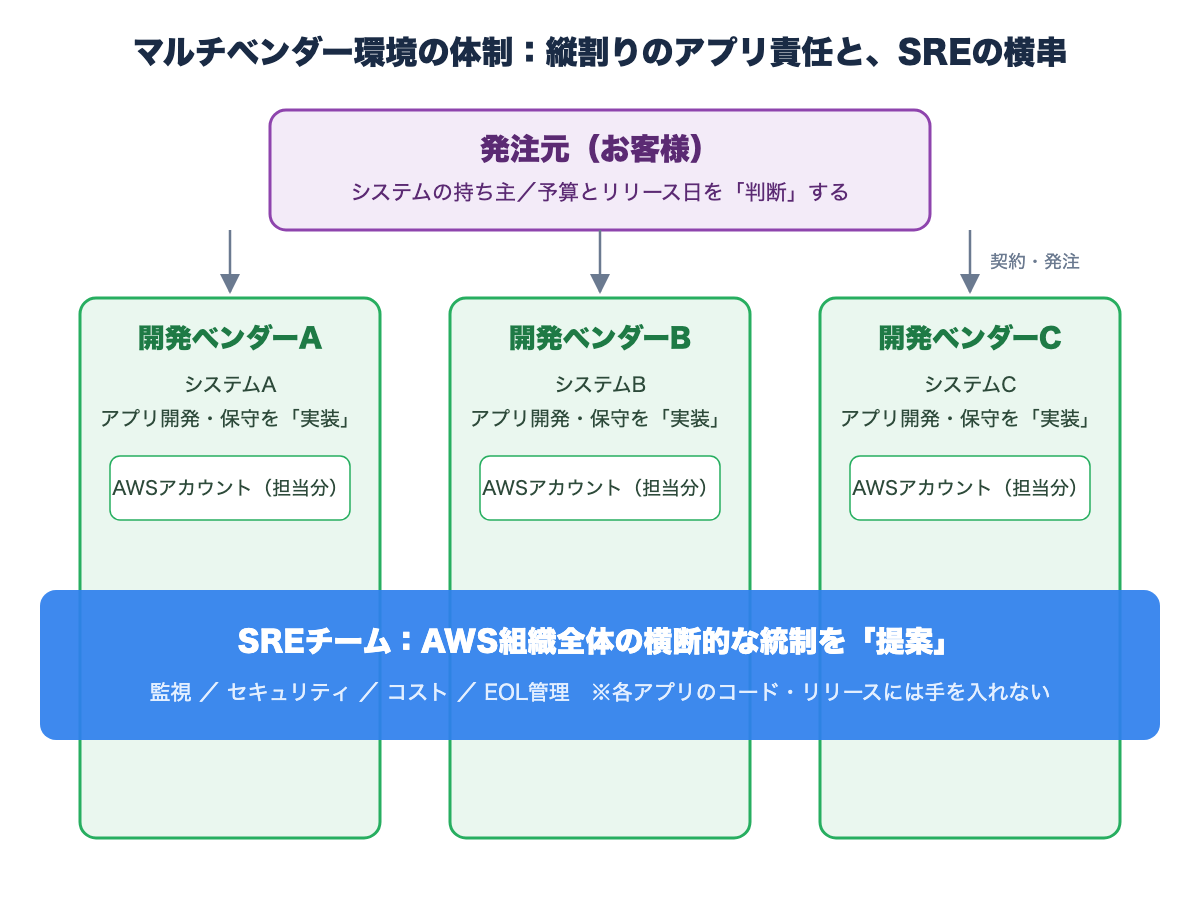
図1:アプリの責任はベンダーごとの縦割り、横断的な統制はSREの横串
ポイントは、SREチームはAWSの組織全体を管理できても、各ベンダーが作ったアプリケーションのコードやリリースには関われないことです。
たとえばSREが「このIAMユーザーのアクセスキーは危ないので消しましょう」と提案するとします。
しかし、そのキーを使っている処理を書き直せるのは開発ベンダーだけです。
さらに、本番に反映する日を決めるのは発注元です。
改善の提案・実装・判断が、3つの立場に分かれている。
これが「責任境界の断絶」の正体です。
2. 改善が「動かない」3つのパターン
改善課題の多くは、実際には順調に完了していきます。
問題は、いつまでも残り続ける一部の課題です。
その止まり方には、大きく3つのパターンがあります。
2-1. パターン①:直すと別のところが壊れる(技術的な依存)
一見すると簡単な改善が、調べてみるとアプリケーションの奥深くにつながっていることがあります。
よくあるのが、古い認証情報や過剰な権限の整理です。
「使われていないはずの認証情報を消す」だけの作業に見えても、調べるうちに次のようなことがわかってきます。
- 開発者がふだんの調査や運用作業に使っている
- 定期的なバッチ処理や、インフラの更新作業がその認証情報に頼っている
- 代わりの方法に切り替えると、処理時間や認証の有効期限などの制約で別の問題が起きる
こうなると、コードの修正、検証、本番への反映が必要になります。
それを担えるのは開発ベンダーだけです。
ここで大事なのは、開発ベンダーは「動いていない」わけではないということです。
多くの場合、定例で状況を報告し、検証も進めています。
ただ、SREの改善課題は、ベンダーにとっては契約上の「本業」(機能開発や保守)の後回しになりやすいのです。
2-2. パターン②:誰が決めるのかが決まっていない(判断の空白)
技術的には難しくないのに、判断する人がいないために止まるパターンです。
- 新しいツールの導入検討で、各ベンダーからの情報は集まったのに、導入するかどうかを決める段階で止まる
- SREが仕組みの検証まで済ませたのに、「やるかどうか」の判断待ちのまま止まる
- 脆弱性の影響調査で、ベンダーの担当分はすぐに回答が来たのに、担当ベンダーがいない領域の確認だけが残る
止まっているのはベンダー側とは限りません。
持ち主がはっきりしない仕事は、関わる会社が増えるほど誰も拾わなくなります。
2-3. パターン③:もっと急ぎの仕事に押し出される(優先度の競争)
障害対応や、より重要な改善テーマが出てくると、進行中の課題の優先度を下げることがあります。
優先度を下げる判断そのものは、多くの場合正しいものです。
問題は、下げた課題をもう一度取り上げるきっかけを用意していないことです。
こうした課題は、気づくと「未対応」のまま何年も残ってしまいます。
3. 突破のための折衝・推進プロトコル
ここからは、私たちが実践している「やり方」を紹介します。
どれも特別なツールは使いません。
課題管理ツールと定期的な定例会議の使い方を工夫したものです。
3-1. SREでできることはSREが行い、ベンダーにしかできないことだけを依頼する
まず大事なのは、横断的な仕事を、SREの担当範囲の中で完結する形に設計することです。
ベンダーにお願いするのは、アプリのコード修正やリリースのように、ベンダーにしかできない作業だけに絞ります。
たとえばEOL(サポート終了)の管理では、AWSの組織全体で設定できる機能(Amazon InspectorのSBOM出力や、AWS Configのアグリゲータなど)を使えば、ベンダーに作業をお願いしなくてもバージョン情報を集められます。
データの取得と優先度の仕分けはSREが担当し、ベンダーにお願いするのは「期限が近いもののバージョンアップ」だけに絞り込めます。
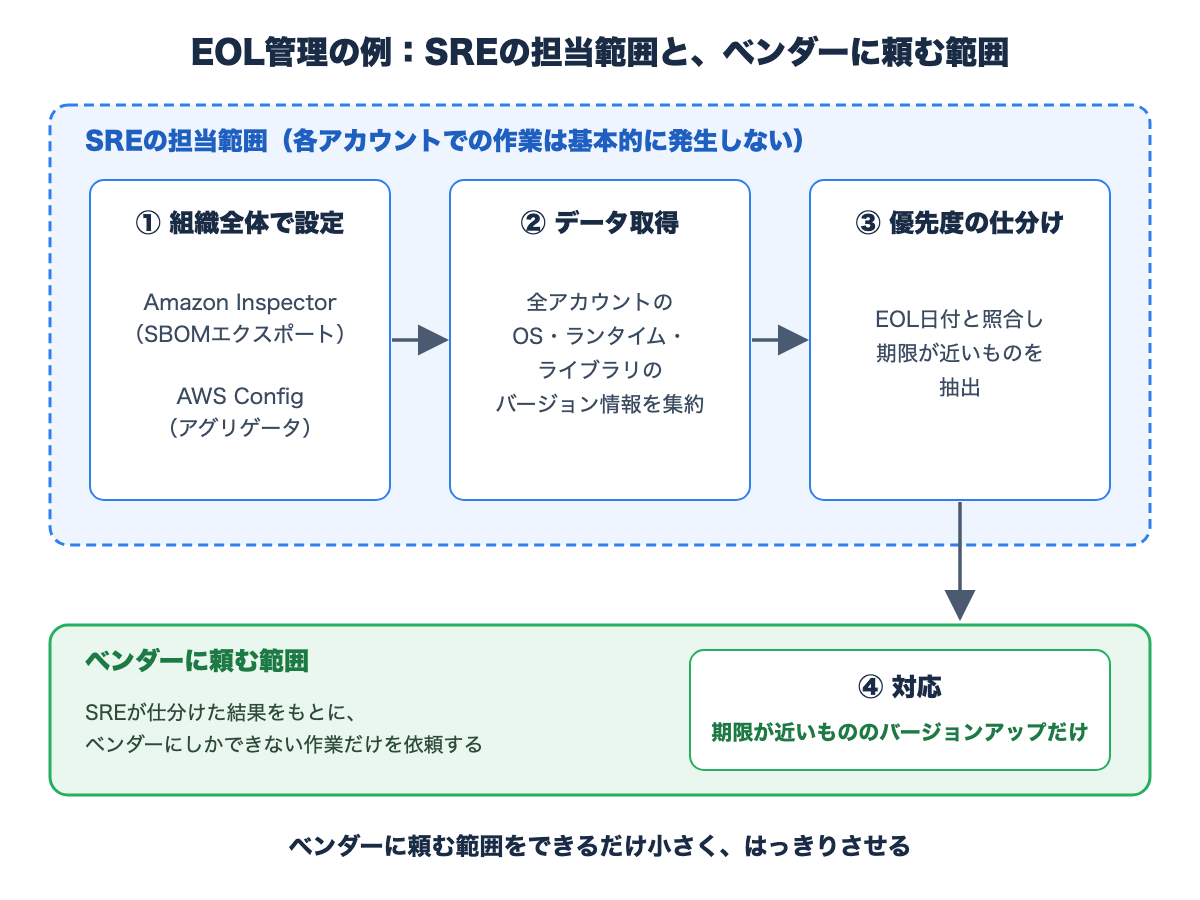
図2:EOL管理におけるSREの担当範囲と、ベンダーに頼む範囲
新しい取り組みを提案すると、発注元からは「各アカウントでの作業は発生するのか」とよく聞かれます。
ここで「基本的に発生しません」と答えられるように設計しておくと、合意までの時間が大きく縮まります。
ベンダーに頼む範囲をできるだけ小さく、はっきりさせる。
これが、責任境界をまたぐ仕事を回すための一番のコツだと考えています。
3-2. 新しい仕組みは「SREの担当範囲で試してから」広げる
新しいセキュリティの仕組みを全体に広げるときは、まずSREが直接担当している環境で試し、コストと運用の実績を見せてから提案します。
自分たちで先に試すことで、ベンダーに「検証してください」とお願いする必要がなくなります。
発注元にとっても、予想コストや運用の手間が具体的に見えるので判断しやすくなります。
3-3. 「SREがやること」と「ベンダーにお願いすること」を分けて書く
課題の本文には、TODOを担当の会社ごとに書きます。
## TODO
* [ ] 対象の処理で使っていないことを確認する @開発ベンダー
* [ ] 不要な設定を削除する @SRE
## 完了の条件
* 上記のTODOがすべて終わったら
こう書くと、「SREがやってくれると思っていた」「ベンダー待ちだと思っていた」という食い違いがなくなります。
完了の条件を最初に決めておくことで、課題がいつまでも終わらない状態も防げます。
3-4. 依頼は「ベンダーごと」に分けて起票する
複数のベンダーに同じことを確認したいとき(脆弱性の影響調査など)は、課題をベンダーごとに別々に起票します。
1つの課題にまとめてしまうと、「誰かが答えるだろう」という空気が生まれます。
担当がはっきりした課題を1社に1件ずつ用意するだけで、回答はぐっと早くなります。
さらに、依頼文には次の3つを必ず書きます。
- 判定の基準:どの条件なら影響あり/なしか
- 回答の形:「影響がない場合はその旨を、ある場合はまず『影響あり』とだけ」
- 日程の決め方:「対応日時は各ベンダーから発注元へ直接調整してください」
答えるための手間を減らすことが、一番の近道です。
なお、担当のベンダーがいない領域が残った場合は、「誰が担当するか」そのものを議題にして、発注元に決めてもらいます(3-5)。
3-5. 選択肢と、「何もしない」案もあわせて出す
権限の扱いのように、セキュリティと現場の使いやすさがぶつかるテーマでは、選択肢を並べて発注元に選んでもらう形で議題にします。
たとえば「通常の作業でも強い権限が必要なので、ずっと付けておいてほしい」という要望には、次のような案を並べます。
- 権限はそのままにして、危険な操作を検知・通知する仕組みを入れる
- 何もしない(監査ログなど、別の手段でリスクを抑えられている場合)
- ずっとは付けず、必要なときに申請してもらう
「何もしない」案を正直に並べると、発注元はリスクをわかったうえで判断できます。
SREが「絶対にやるべきです」と押すだけでは、ベンダーの現場の事情と正面からぶつかって話が止まります。
最後の判断を持ち主である発注元に渡すことで、話が前に進むようになります。
3-6. 優先順位は定例で発注元に決めてもらい、記録する
技術的な依存がからむ課題(パターン①)は、ベンダーに直してもらうしかありません。
ここで止まる一番の理由は、SREの改善課題とベンダーの本業のどちらを先にやるかが、誰にも決められていないことです。
そこで、定例会議の場で発注元に、機能開発とSREの改善課題を同じ並びで比べて、順番を決めてもらいます。
SREとベンダーの2社だけで決めようとすると、「判断の空白」(パターン②)に戻ってしまいます。
予算とリリース日を決めている発注元が判断することで、「なんとなく後回し」が「合意した順番」に変わります。
いまの契約の範囲ではどうしても手が回らない場合は、作業の追加や契約の見直しについても、発注元とベンダーの間で合意を取ってもらいます。
決まった内容は、議事メモと同じく課題のコメントに残します(3-8)。
「いつ・誰が・何を優先すると決めたか」が残っていれば、あとで順番が入れ替わっても経緯を説明できます。
3-7. 優先度を下げた課題は、見直す日を決めてアジェンダに戻す
障害対応などで優先度を下げること自体は問題ありません。
問題は、下げた課題がそのまま忘れられることです(パターン③)。
そこで、優先度を下げるときは、課題に「次に見直す日」(または「○○のリリース後」などの条件)を書いておきます。
その日が来た課題は定例会議のアジェンダに載せ、続けるか、さらに延ばすか、閉じるかを決めます。
未対応の課題を毎回すべて読み上げると、会議が重くなり、やがて読み飛ばされるようになります。
見直す日が来たものだけを載せることで、定例を軽く保ちながら、課題が埋もれるのを防げます。
あわせて、四半期に一度は止まっている課題をまとめて見直す時間を取ると、見落としを減らせます。
3-8. 定例会議の議事メモは「課題のコメント」として残す
定例会議の議事メモは、議事録のファイルにまとめるだけでなく、話した課題それぞれにコメントとして書き込みます。
## ○/○ 定例MTGメモ
* 進捗はあるか(SRE)
    * まだ確認できていない。対応する(発注元)
        * 承知した(SRE)
こうすると、課題を開くだけで「いつ・誰が・何と言ったか」がすべてわかります。
同じ「進捗なし」が何回続いているかも一目でわかるので、止まっていることを、誰かを責めずに事実として示せます。
記録が積み重なれば、「優先度が低いのであれば、いったん閉じて改めて起票しましょう」と提案することもできます。
課題を閉じるのも、立派な前進です。
4. それでも残る課題
正直に言うと、このやり方で全部が解決するわけではありません。
- 技術的な依存がからむ課題(2-1)は、やはり時間がかかる。優先順位を決めて止まらないようにはできても、コードの修正・検証・本番への反映にかかる時間そのものは短くできません。
- 契約の枠組みの問題。SREの改善課題をベンダーの保守契約の中にどう位置づけるかは、技術ではなく契約の話です。SREの導入を計画する段階で、発注元と一緒に「改善課題への協力」を各ベンダーとの契約に書き込んでおくのが理想だと考えています。
5. おわりに
マルチベンダーのエンタープライズ環境でSREが進まないとき、その原因は「ベンダーが動かない」ことではありません。
多くの場合、改善の提案・実装・判断が別々の会社に分かれていて、そのつなぎ目に持ち主がいないことが原因です。
この記事で紹介したプロトコルをまとめると、次の5つになります。
どれも地味ですが、マルチベンダー環境でSREを回していくうえで効果のあるやり方です。
当社では、こうしたマルチベンダー環境でのSRE導入・運用を支援しています。
「SREを入れたいが、既存のベンダー体制の中でどう進めればよいかわからない」という方は、ぜひお気軽にお問い合わせください。
最初の一歩を一緒に整理しましょう。
関連記事
「セキュリティアラートの50%以上は未対応のまま放置されている」 2023年にIBM と Morning Consultが実施した調査の結果は、セキュリティチームが直面する厳しい現実を示しています。 その原因は、リソース不足と、日々大量に届く通知によるアラート疲労。 アラートが発生しても実際に確認すればほとんどが問題ない。にもかかわらず毎日大量のアラートが通知される。 このような状況では「どうせいつもの過検知だろう」と油断が生まれ、アラートが実質的には機能
マルチクラウドやハイブリッド環境が当たり前になったいま、SREやDevOpsチームの皆様は、こんな悩みを抱えていないでしょうか。 サービスと環境が増え続け、全体像が誰の頭にもない 各社クラウド・オンプレが入り組み、障害原因の切り分けに時間がかかりすぎる デプロイ起因の障害はコード変更まで追うのが大変 こうした課題を打破するのが、2026年3月に一般提供開始された「AWS DevOps Agent」です。 本記事では、その概要とAIエージェントを真の戦力にす
目次 はじめに:障害対応の現場で起きている課題 AIが一次調査を肩代わりする 実務に組み込むための検討ポイント まとめ:AIと共同の障害対応で改善のサイクルへ 出典 1. はじめに:障害対応の現場で起きている課題 深夜や休日に届くアラート通知。 慌ててPCを開き、メトリクス、ログ、デプロイ履歴のタブを行き来しながら、頭の中で突き合わせていく作業は、時間的にも精神的にも大きな負担です。また、素早い対応が必要な場面では「まずここを見る」とい
深夜のアラート対応、障害調査のログ突き合わせ、セキュリティ検知のトリアージ。毎月の報告書は「異常なし」なのに、同じインシデントが繰り返される。そんなシステム運用に疲弊していませんか。 原因は担当者の能力でも姿勢でもなく、体制にあります。安定を守る責任が重いほど、改善に割く余力は構造的になくなっていくためです。このことを改善する方法がSRE(Site Reliability Engineering)ですが、必要なエンジニアリングコストの高さが導入の壁でした